
Provedores personalizados
Converse pelo seu próprio endpoint e chave.
Adicione qualquer endpoint compatível com OpenAI com nome, URL base e chave de API. O provedor e a chave ficam só no seu banco de dados local.
Modelos personalizados aparecem no seletor de modelos junto aos do catálogo. Uma conversa pode alternar entre eles livremente.
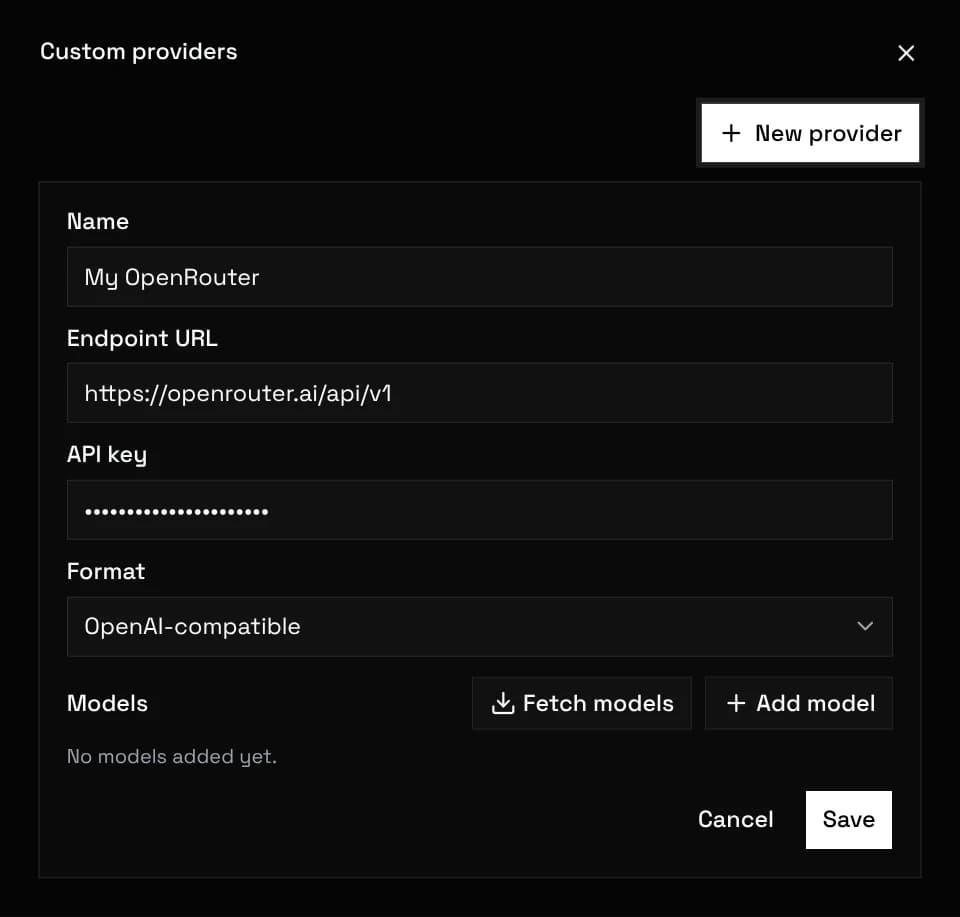
Carregue a lista de modelos do provedor, pesquise e marque os modelos que quiser; só os marcados aparecem no seletor do chat. Um ID que não está na lista pode ser digitado na busca e adicionado. Cada modelo é do tipo texto ou imagem. Modelos do tipo imagem alimentam o gerador de imagens, não o menu do chat.
Cada entrada de modelo carrega as próprias configurações, incluindo o tokenizador usado no orçamento.
A contagem de tokens comanda o corte do histórico e os orçamentos de lorebook, então o tokenizador certo importa em chats longos. Cada modelo personalizado escolhe entre 13 predefinições:
auto cl100k o200k claude glm5 glm4 deepseek deepseek-v4 llama3 gemma qwen mistral cohere
Ou aponte para qualquer tokenizador do HuggingFace por slug ou URL:
hf:openai-community/gpt2
hf:https://huggingface.co/Qwen/Qwen2.5-7B/resolve/main/tokenizer.json
Tokenizadores do HuggingFace baixam uma vez e ficam em cache local. A contagem nunca bloqueia um envio: se um tokenizador falhar ao carregar, um reserva aproximado conta no lugar.
Modelos do catálogo podem ser roteados por um grupo de cobrança que serve de base para chats novos. Modelos de provedores personalizados não passam pelo roteamento, então o grupo não tem efeito sobre eles.
Requisições a provedores próprios vão direto do seu navegador para o seu endpoint. Os servidores do UnoRouter nunca veem a requisição, a resposta nem a sua chave do provedor.