
Własni dostawcy
Czatuj przez własny endpoint i własny klucz.
Dodaj dowolny endpoint zgodny z OpenAI z nazwą, bazowym URL i kluczem API. Dostawca i jego klucz są przechowywane wyłącznie w twojej lokalnej bazie.
Własne modele pojawiają się na liście modeli obok modeli z katalogu. Rozmowa może swobodnie przełączać się między nimi.
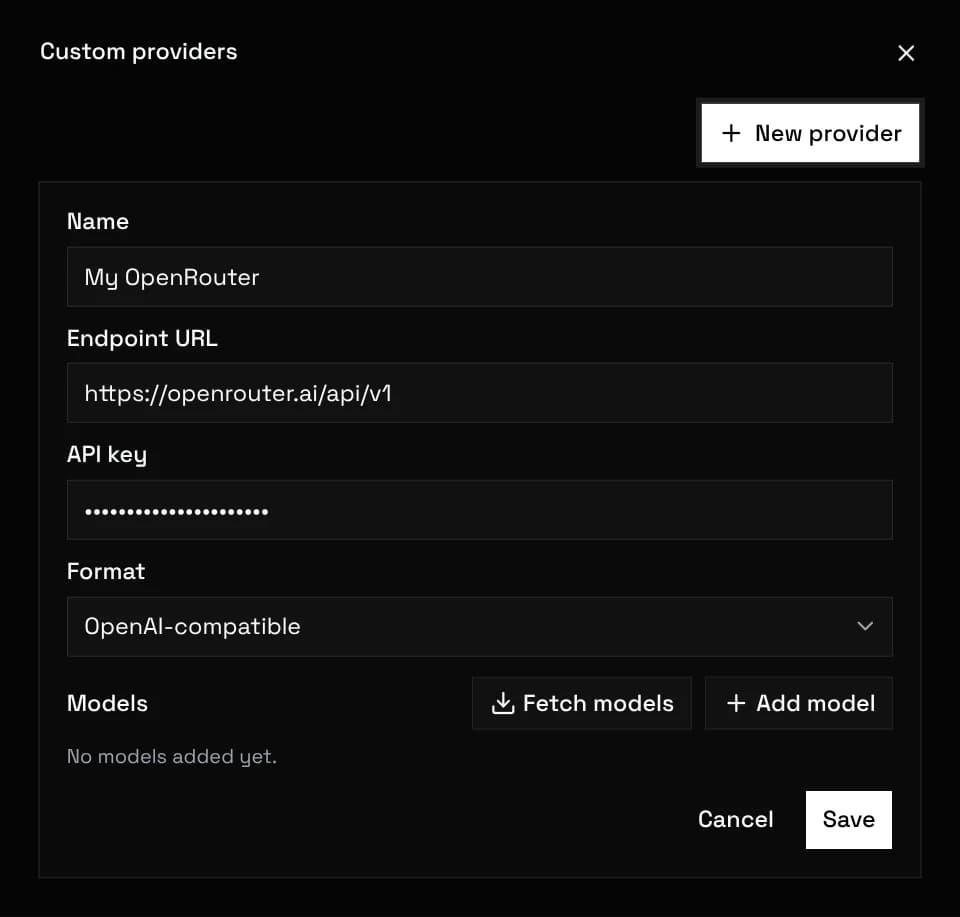
Wczytaj listę modeli dostawcy, przeszukaj ją i zaznacz potrzebne modele; w wyborze w czacie pojawiają się tylko zaznaczone. ID modelu, którego nie ma na liście, można wpisać w wyszukiwarkę i dodać. Każdy model ma typ tekst albo obraz. Modele typu obraz zasilają generator obrazów, a nie listę w czacie.
Wpisy modeli niosą własne ustawienia, w tym tokenizer używany do budżetowania.
Liczenie tokenów steruje przycinaniem historii i budżetami lorebooków, więc właściwy tokenizer ma znaczenie w długich czatach. Każdy własny model wybiera z 13 presetów:
auto cl100k o200k claude glm5 glm4 deepseek deepseek-v4 llama3 gemma qwen mistral cohere
Albo wskaż dowolny tokenizer HuggingFace przez slug lub URL:
hf:openai-community/gpt2
hf:https://huggingface.co/Qwen/Qwen2.5-7B/resolve/main/tokenizer.json
Tokenizery HuggingFace pobierają się raz i są keszowane lokalnie. Liczenie nigdy nie blokuje wysyłki: gdy tokenizer się nie wczyta, liczy przybliżony zapasowy.
Modele z katalogu mogą być kierowane przez grupę rozliczeniową, która zasila nowe czaty. Modele z własnego dostawcy omijają routing, więc grupa nic dla nich nie zmienia.
Żądania do własnych dostawców idą prosto z twojej przeglądarki na twój endpoint. Serwery UnoRouter nigdy nie widzą żądania, odpowiedzi ani twojego klucza dostawcy.